SemiAnalysis merilis GDPx, benchmark baru untuk mengukur kemampuan agen AI di 11 domain bernilai ekonomi tinggi, pada Senin (2/11/2026) pukul 09.06 WIB. Hasilnya, Claude Opus 5.5 buatan Anthropic menempati peringkat pertama dengan skor hanya 12,0%, disusul Gemini 4 Carbon milik Google (10,9%) dan GPT-6 Astra dari OpenAI (9,6%).
Pengumuman itu disampaikan lewat utas resmi @SemiAnalysis_ di X dan blog SemiAnalysis, lengkap dengan situs papan peringkat GDPx. SemiAnalysis mengklaim GDPx sebagai benchmark kelas frontier sejati karena model terbaik pun baru menyelesaikan sebagian kecil tugasnya.
Fakta singkat
- Nama benchmark: GDPx v1.0
- Pembuat: SemiAnalysis, ditulis Max Kan, Andrew Megalaa, dan Dylan Patel
- Rilis: Senin, 2 November 2026, 09.06 WIB
- Cakupan: 11 domain, 14 mitra data, 206 tugas
- Peringkat 1: Claude Opus 5.5 (Anthropic), skor 12,0%, biaya US$51,41 per tugas
- Metode skor: rata-rata 11 domain dengan bobot setara (begitu pula tiap mitra dalam satu domain); skor tiap tugas adalah rata-rata dari 3 percobaan
Apa itu benchmark GDPx dari SemiAnalysis?
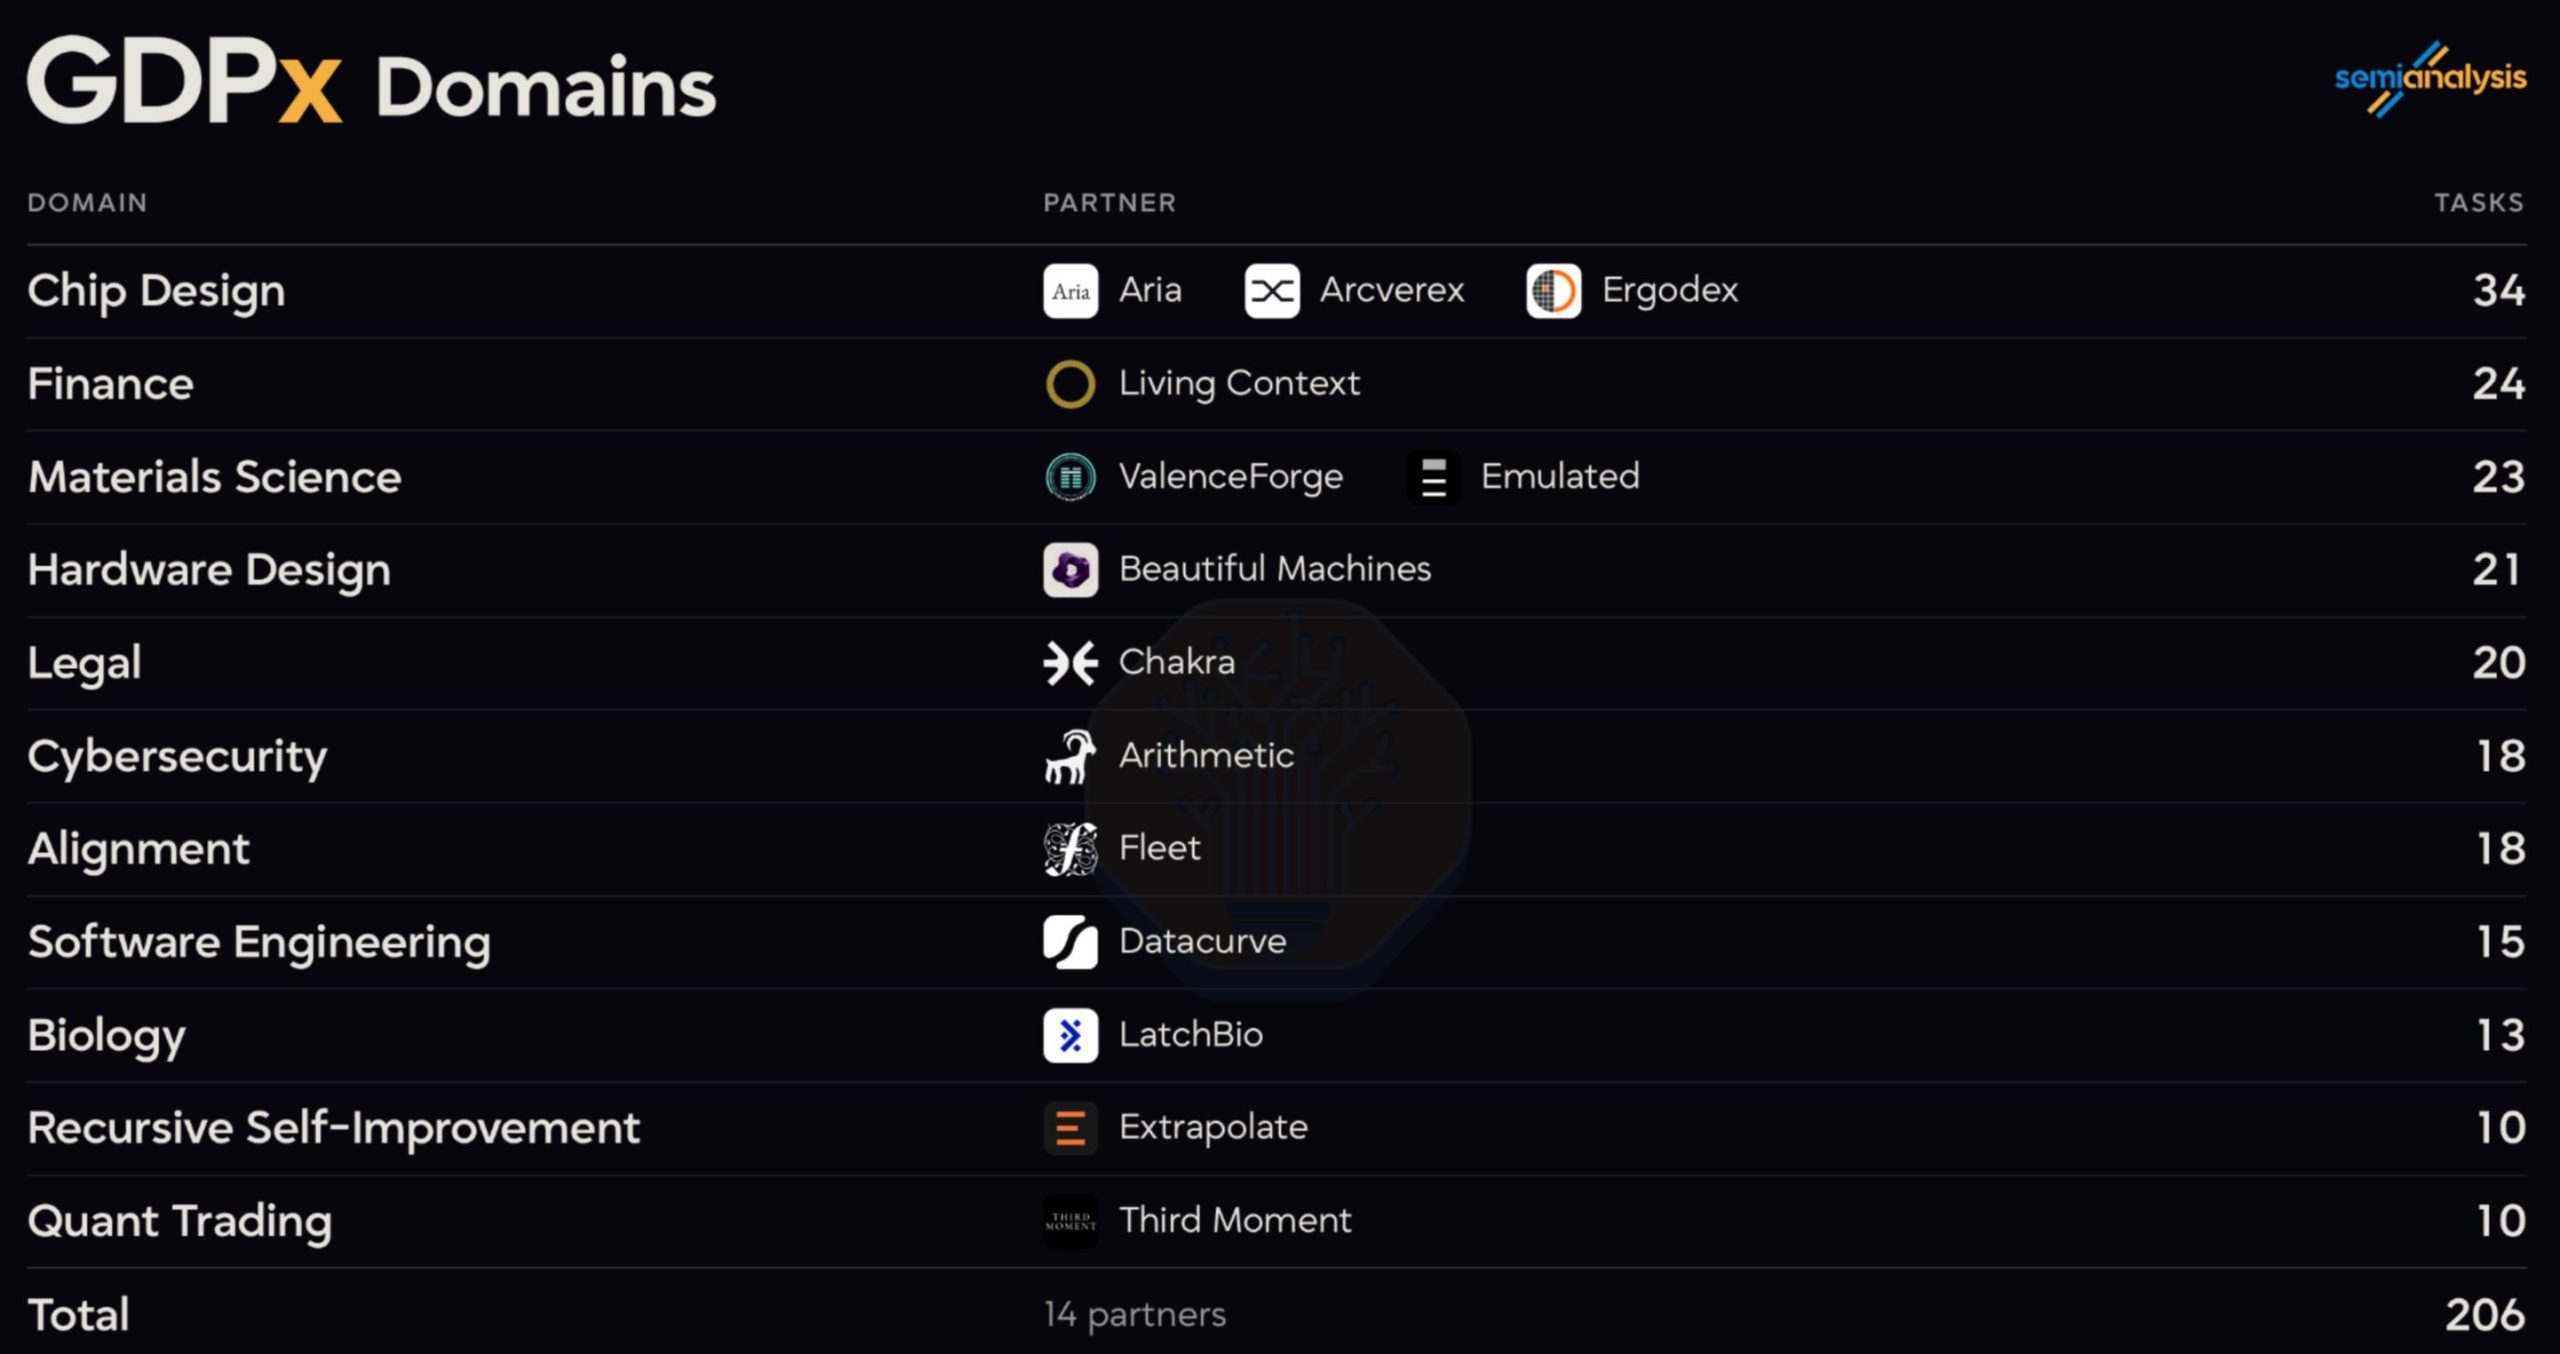
GDPx adalah benchmark untuk mengukur kemampuan agen AI umum di domain yang paling bernilai bagi kecerdasan buatan kelas frontier. Isinya 206 tugas di 11 domain, mulai dari desain chip, keamanan siber, biologi, hingga hukum, yang masing-masing disusun bersama minimal satu mitra data spesialis.
Menurut SemiAnalysis, triliun dolar pertama pendapatan AI akan terpusat di sektor yang bisa memakai AI frontier dengan imbal hasil tinggi, bukan tersebar merata di seluruh ekonomi. Karena itu, GDPx sengaja tidak memasukkan industri seperti pemerintahan, real estat, dan asuransi.
| Domain | Mitra data | Jumlah tugas |
|---|---|---|
| Desain chip | Aria, Arcverex, Ergodex | 34 |
| Keuangan | Living Context | 24 |
| Ilmu material | ValenceForge, Emulated | 23 |
| Desain hardware | Beautiful Machines | 21 |
| Hukum | Chakra | 20 |
| Keamanan siber | Arithmetic | 18 |
| Alignment | Fleet | 18 |
| Rekayasa perangkat lunak | Datacurve | 15 |
| Biologi | LatchBio | 13 |
| Recursive self-improvement (RSI) | Extrapolate | 10 |
| Quant trading | Third Moment | 10 |
| Total | 14 mitra | 206 |
SemiAnalysis juga menyebut benchmark GDPval milik OpenAI, yang dirilis 25 September 2025, sudah tidak memadai untuk menilai model frontier saat ini. Alasannya, desain tugas GDPval dibuat ketika agen AI belum umum dipakai.
Model AI apa yang teratas di GDPx?
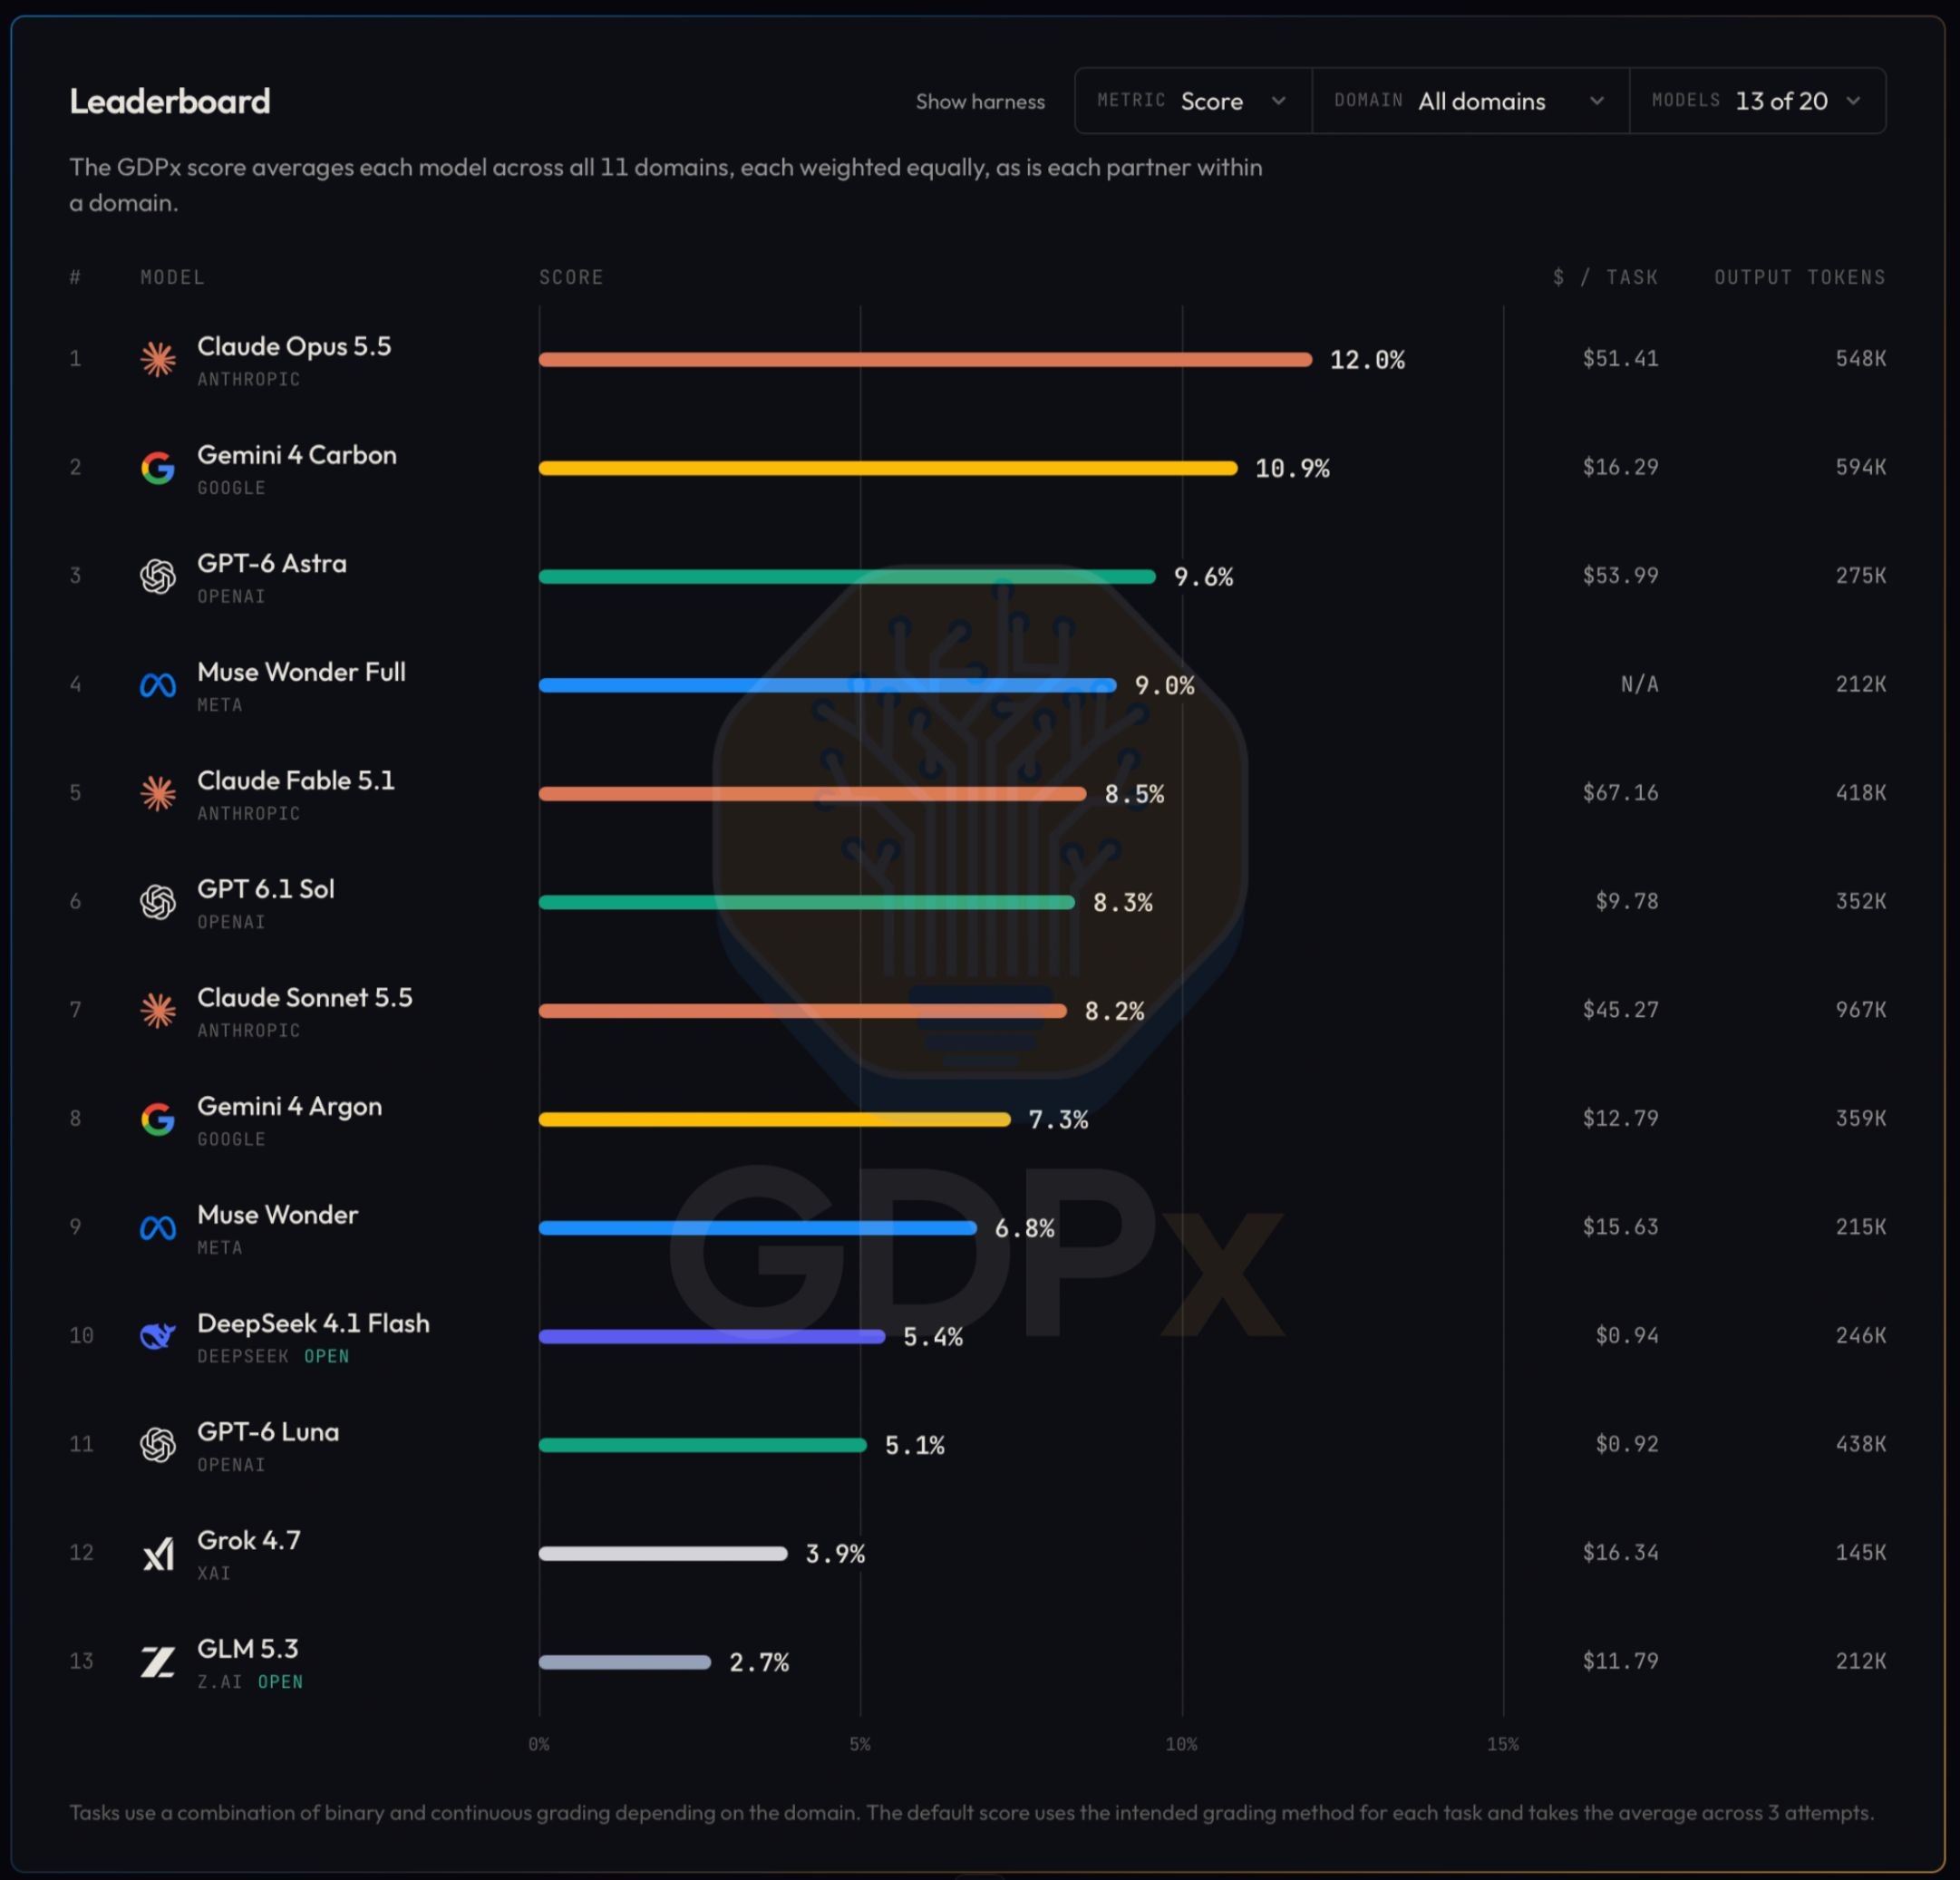
Claude Opus 5.5 dari Anthropic menempati peringkat pertama GDPx dengan skor rata-rata 12,0% di seluruh domain. Gemini 4 Carbon dari Google menyusul di posisi kedua dengan 10,9%, lalu GPT-6 Astra dari OpenAI di posisi ketiga dengan 9,6%, sementara Muse Wonder Full milik Meta berada di urutan keempat dengan 9,0%.
| # | Model | Pembuat | Skor GDPx | Biaya per tugas |
|---|---|---|---|---|
| 1 | Claude Opus 5.5 | Anthropic | 12,0% | US$51,41 |
| 2 | Gemini 4 Carbon | 10,9% | US$16,29 | |
| 3 | GPT-6 Astra | OpenAI | 9,6% | US$53,99 |
| 4 | Muse Wonder Full | Meta | 9,0% | Tidak tersedia |
| 5 | Claude Fable 5.1 | Anthropic | 8,5% | US$67,16 |
| 6 | GPT 6.1 Sol | OpenAI | 8,4% | US$9,80 |
| 7 | Claude Sonnet 5.5 | Anthropic | 8,2% | US$45,27 |
| 8 | Gemini 4 Argon | 7,3% | US$12,79 | |
| 9 | Muse Wonder | Meta | 6,8% | US$15,63 |
| 10 | DeepSeek 4.1 Flash | DeepSeek | 5,4% | US$0,94 |
| 11 | GPT-6 Luna | OpenAI | 5,1% | US$0,92 |
| 12 | Grok 4.7 | xAI | 3,9% | US$16,34 |
| 13 | GLM 5.3 | Z.ai | 2,7% | US$11,79 |
Tabel di atas mengikuti data situs GDPx per 2 November 2026 dan memuat 13 model yang tampil di tampilan utama, dari total 20 model yang diuji. Grafik yang dibagikan SemiAnalysis saat rilis masih mencantumkan GPT 6.1 Sol di 8,3% dengan biaya US$9,78 per tugas, sedangkan situs GDPx kini menampilkan 8,4% dan US$9,80. Urutan peringkatnya tidak berubah.
Gemini 4 Carbon menonjol karena biayanya. Skornya hanya terpaut 1,1 poin dari Opus 5.5, tetapi biaya per tugasnya US$16,29 atau sekitar sepertiga dari Opus. SemiAnalysis menyebut Carbon sebagai peningkatan nyata dari Google dan satu-satunya model yang selevel dengan Opus serta Astra. Model ini sebelumnya sudah dibahas Gizmokrat saat Google mengumumkan Gemini 4 Carbon.
CEO Google Sundar Pichai ikut menanggapi lewat unggahan di X pada Senin pukul 11.34 WIB. Ia menulis senang melihat benchmark berkualitas tinggi yang masih menyisakan ruang dan menyoroti garis biaya Carbon.
Mengapa skor Claude Opus 5.5 dan GPT-6 Astra disebut tertahan?
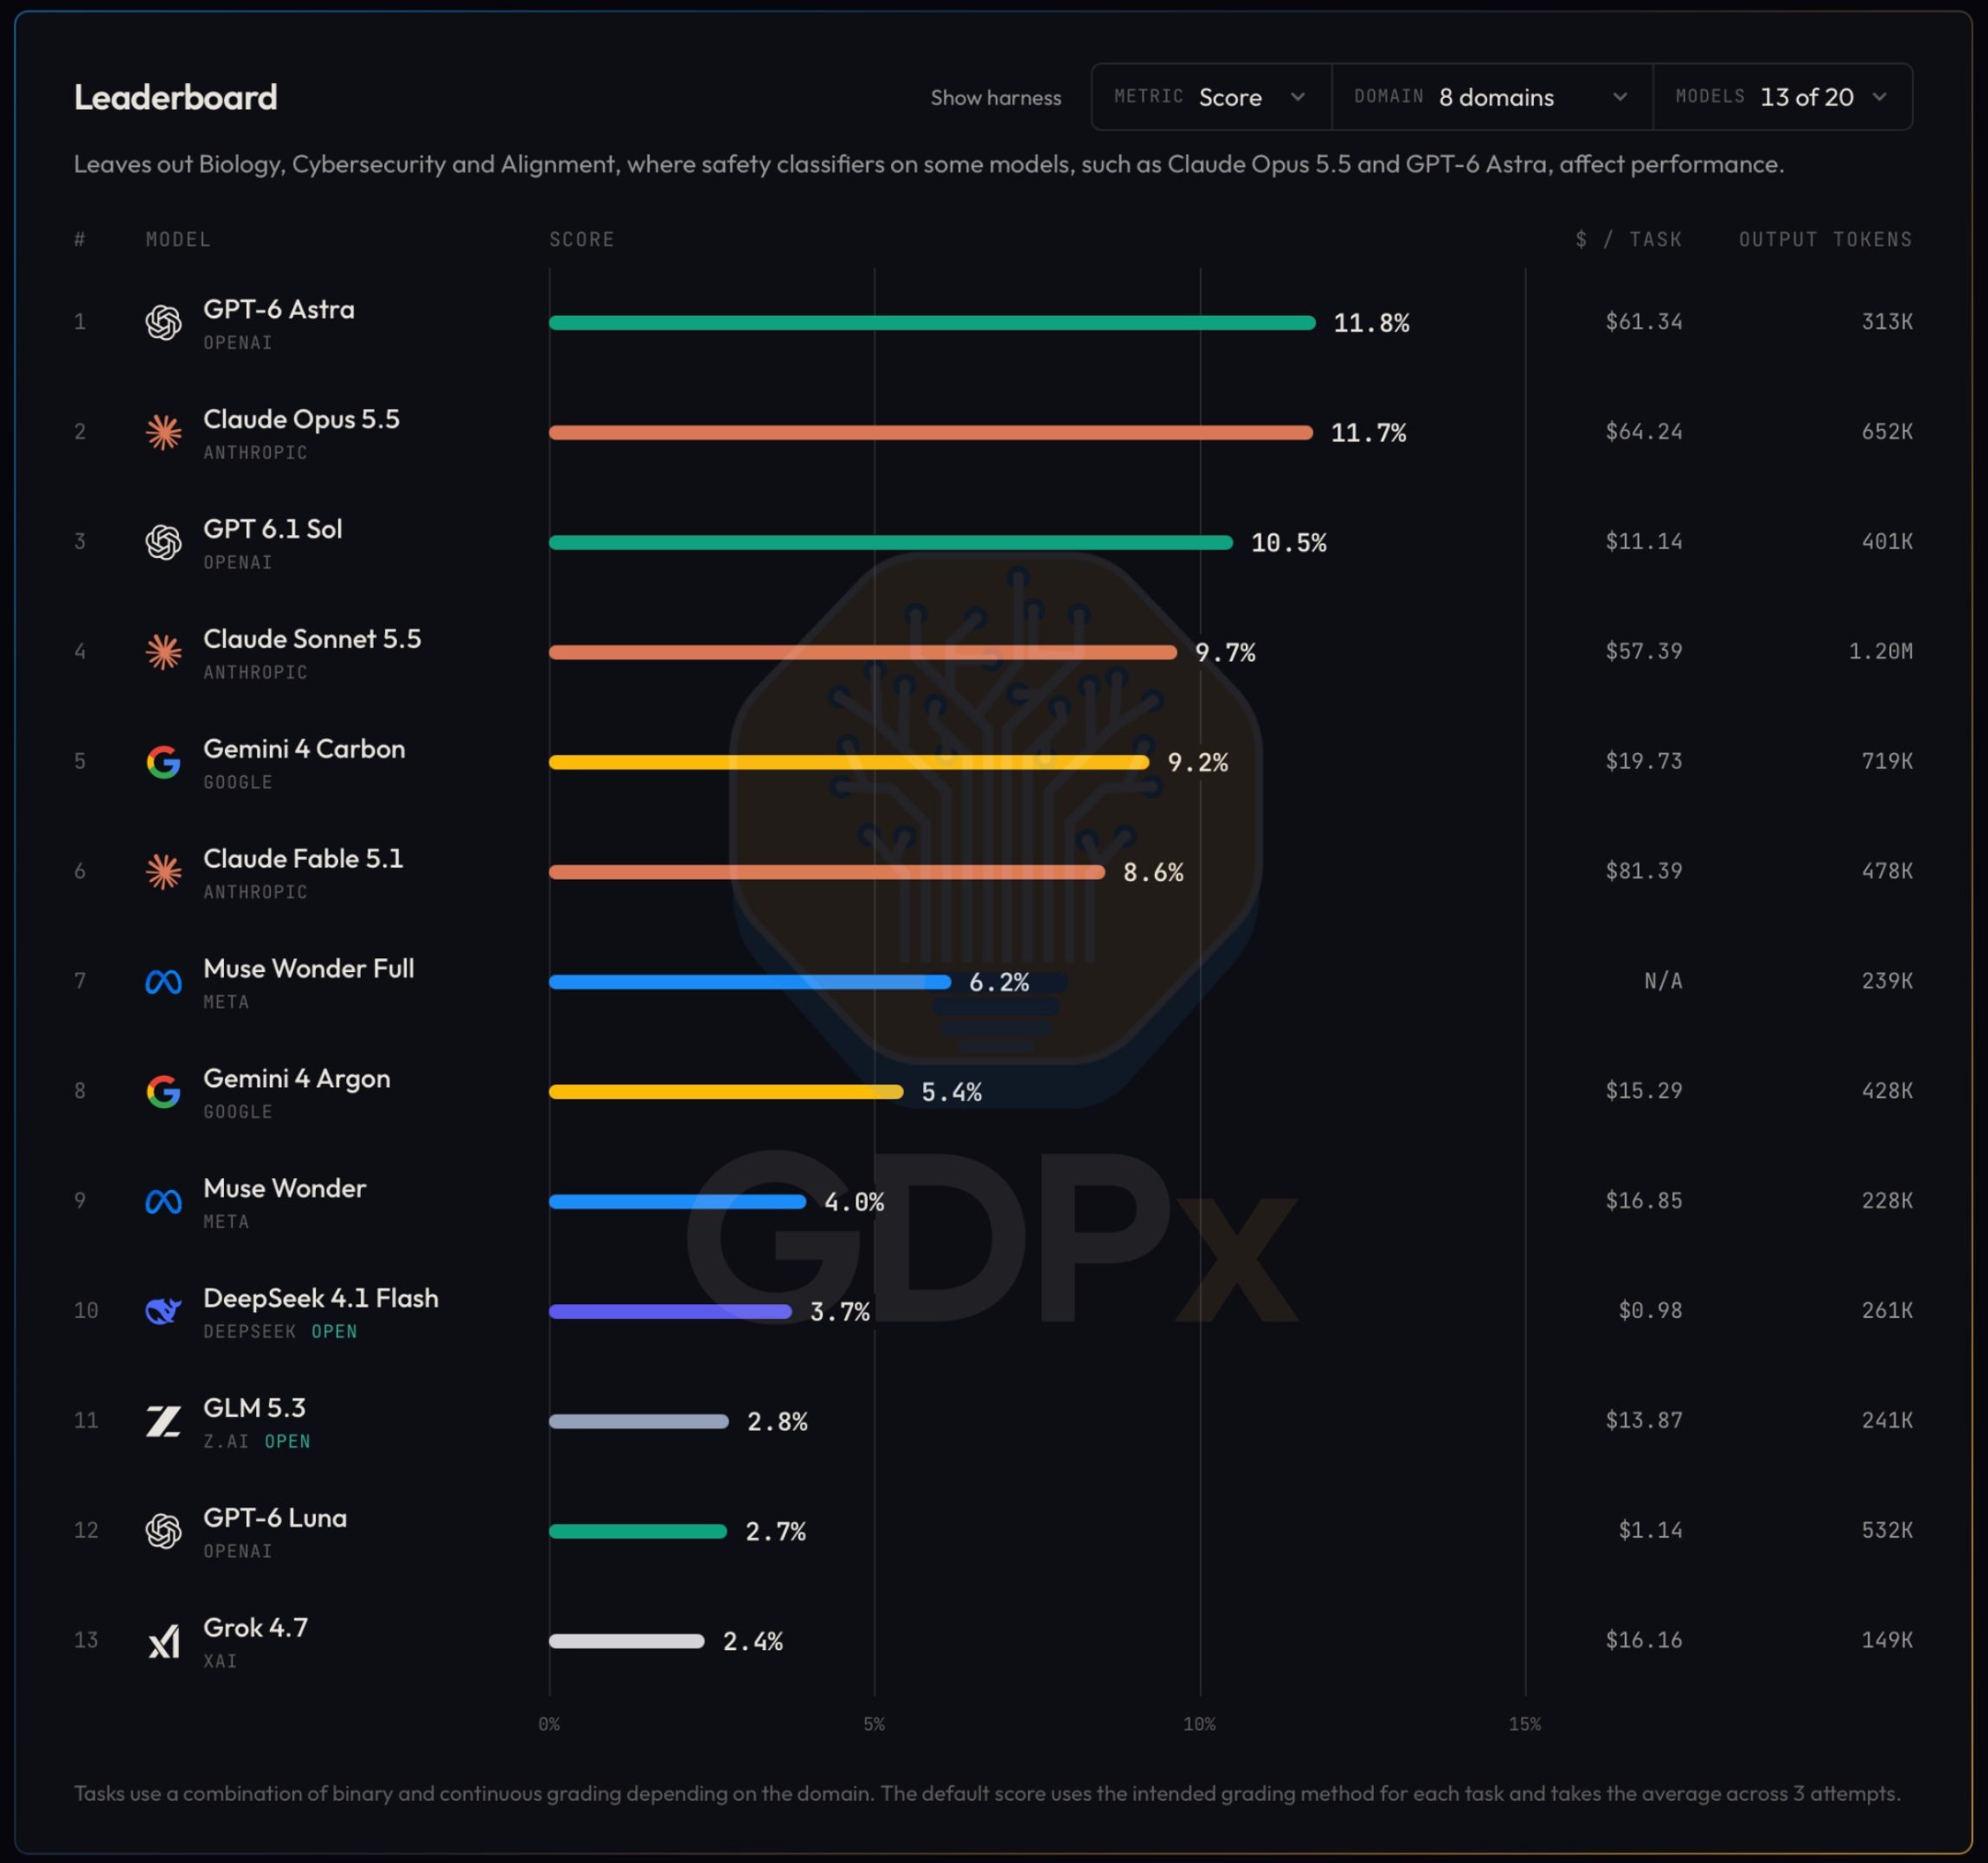
Skor Claude Opus 5.5 dan GPT-6 Astra disebut tertahan karena pengklasifikasi keamanan (safety classifier) kedua model kadang aktif di domain keamanan siber, biologi, dan alignment. Jika tiga domain itu dikeluarkan, GPT-6 Astra justru naik ke posisi pertama dengan skor 11,8%, tipis di atas Opus 5.5 yang mencatat 11,7%. Berikut lima teratas dari 13 model di tampilan utama, menurut data situs GDPx per 2 November 2026.
- GPT-6 Astra (OpenAI): 11,8%
- Claude Opus 5.5 (Anthropic): 11,7%
- GPT 6.1 Sol (OpenAI): 10,6% (10,5% di grafik saat rilis)
- Claude Sonnet 5.5 (Anthropic): 9,7%
- Gemini 4 Carbon (Google): 9,2%
SemiAnalysis menilai urutan ini sesuai dengan kesan subjektif mereka saat memakai model-model tersebut. OpenAI dan Anthropic mendominasi papan atas, sementara SpaceXAI (pengembang Grok), Meta, dan model open-weight tertinggal cukup jauh.
Per domain, SemiAnalysis menyebut Opus 5.5 sebagai model serba bisa terbaik yang unggul di quant trading, desain hardware, dan desain chip. Namun, di tabel lengkap situs GDPx, Opus 5.5 hanya memimpin desain hardware (18,7%); desain chip dipimpin GPT 6.1 Sol (5,6% berbanding 4,8%), sedangkan quant trading dipimpin Claude Fable 5.1 (28,6% berbanding 27,4%). Gemini 4 Carbon menjadi model terbaik di biologi (25,6%), yang menurut SemiAnalysis kemungkinan karena pengklasifikasi keamanannya lebih longgar, dan ikut memuncaki rekayasa perangkat lunak dengan 11,1%, sama dengan Claude Sonnet 5.5 dan GPT 6.1 Terra. GPT-6 Astra memimpin RSI (24,9%) serta ilmu material (21,6%). Di domain hukum, semua model mendapat skor 0, dan di keuangan hanya Gemini 4 Carbon yang mencetak skor (2,8%). Anthropic sendiri belakangan aktif mendorong agen AI, salah satunya lewat Claude Duet.
Model mana yang terbaik untuk keamanan siber menurut GDPx?
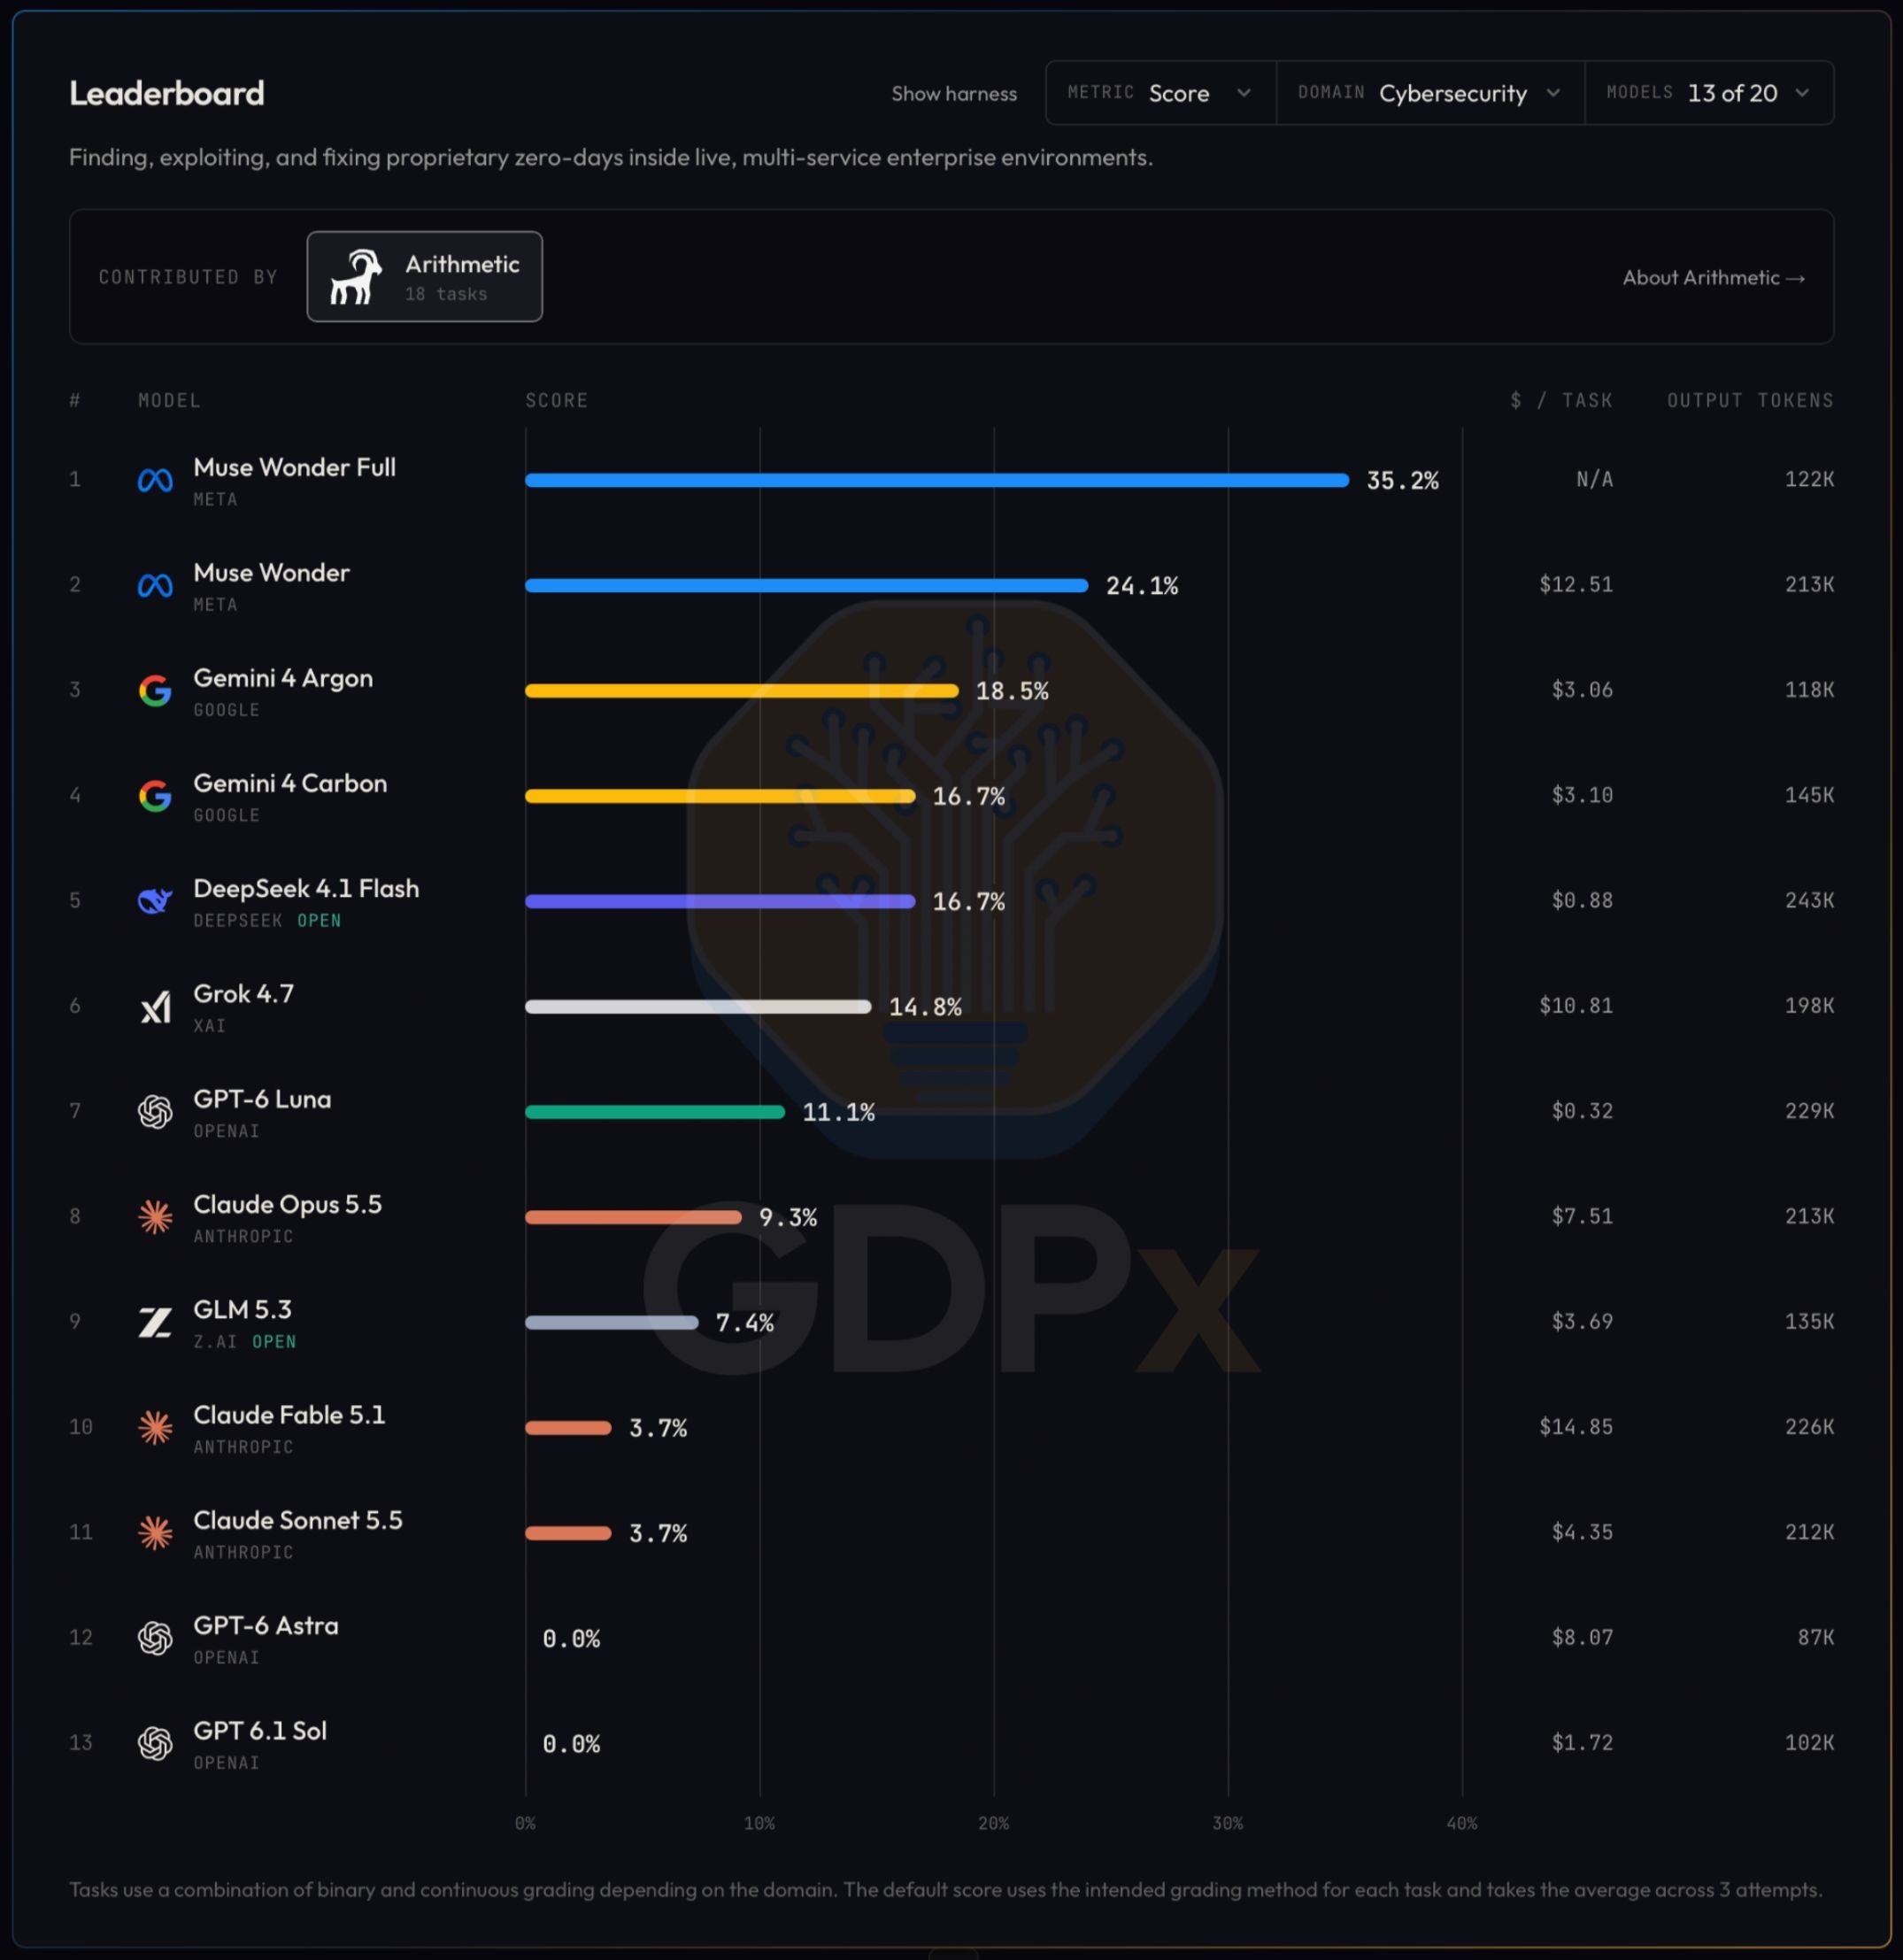
Muse Wonder Full milik Meta menjadi model terbaik untuk keamanan siber di GDPx dengan skor 35,2%, jauh di atas Muse Wonder (24,1%) dan Gemini 4 Argon (18,5%). Domain ini berisi 18 tugas dari Arithmetic untuk menemukan, mengeksploitasi, dan memperbaiki celah zero-day di lingkungan enterprise multi-layanan.
Sebaliknya, GPT-6 Astra dan GPT 6.1 Sol sama-sama mencetak 0,0% di domain ini, sedangkan Claude Opus 5.5 hanya 9,3%. SemiAnalysis menilai pengaruh pengklasifikasi keamanan masih kurang diperhitungkan saat orang memilih model untuk kebutuhan tertentu.
Dari sisi biaya dan performa, SemiAnalysis menyebut GPT-6 Luna dan DeepSeek bersaing di segmen murah, Opus menguasai segmen atas, dan OpenAI mengisi segmen tengah. Muse Wonder Full tidak masuk grafik biaya karena belum punya harga publik. Di luar GDPx, Tencent turut mengklaim Tencent Hy4 mendekati model proprietary di sejumlah benchmark agen.
FAQ seputar benchmark GDPx
Apa itu GDPx?
GDPx adalah benchmark dari SemiAnalysis untuk mengukur kemampuan agen AI di 11 domain bernilai tinggi, seperti desain chip, keamanan siber, dan biologi. Benchmark ini berisi 206 tugas yang disusun bersama 14 mitra data.
Kapan GDPx dirilis?
SemiAnalysis merilis GDPx versi 1.0 pada Senin, 2 November 2026, pukul 09.06 WIB lewat akun X @SemiAnalysis_, blog, dan situs gdpx.semianalysis.com.
Model AI apa yang menempati peringkat pertama GDPx?
Claude Opus 5.5 dari Anthropic menempati peringkat pertama dengan skor 12,0%. Posisi kedua dan ketiga diisi Gemini 4 Carbon dari Google (10,9%) dan GPT-6 Astra dari OpenAI (9,6%).
Mengapa skor tertinggi GDPx hanya 12%?
SemiAnalysis menyebut GDPx sebagai benchmark kelas frontier sehingga model terbaik pun baru menyelesaikan sebagian kecil tugasnya. Di domain hukum semua model mendapat skor 0, dan di keuangan hanya Gemini 4 Carbon yang mencetak skor (2,8%).