BioBasicsBench adalah benchmark OpenAI bersama perusahaan bioteknologi Ligo untuk menilai analisis data mentah dari 100 tugas lab basah. Menurut pengumuman 6 November 2026, GPT-6 Astra memperoleh rata-rata 66,7% dari kredit penilaian pada pengaturan penalaran xhigh. Angka ini bukan persentase eksperimen yang berhasil dijalankan AI secara mandiri.
Akun X resmi @OpenAI membagikan BioBasicsBench pada Sabtu, 7 November 2026 pukul 02.08 WIB. Detail metodologi, skor, dan contoh kegagalan merujuk OpenAI Newsroom bertanggal 6 November 2026.
Fakta singkat BioBasicsBench
- 100 tugas analisis lab basah sehari-hari, dikembangkan OpenAI bersama Ligo
- Lima area: protein methods, imaging and cytometry, quantification and assays, nucleic acid methods, molecular cloning
- GPT-6 Astra: mean reward 66,7% (CI 95% 60,3–73,1%) di xhigh; GPT-6.1 Sol 62,0%; GPT-5.6 Sol 43,8%
- Evaluasi: 7 model, 37 pengaturan, 18.500 hasil (5 percobaan per tugas per pengaturan)
- Input: gel, mikroskop, sequencing, video protokol, foto cawan, ekspor instrumen, dan lainnya
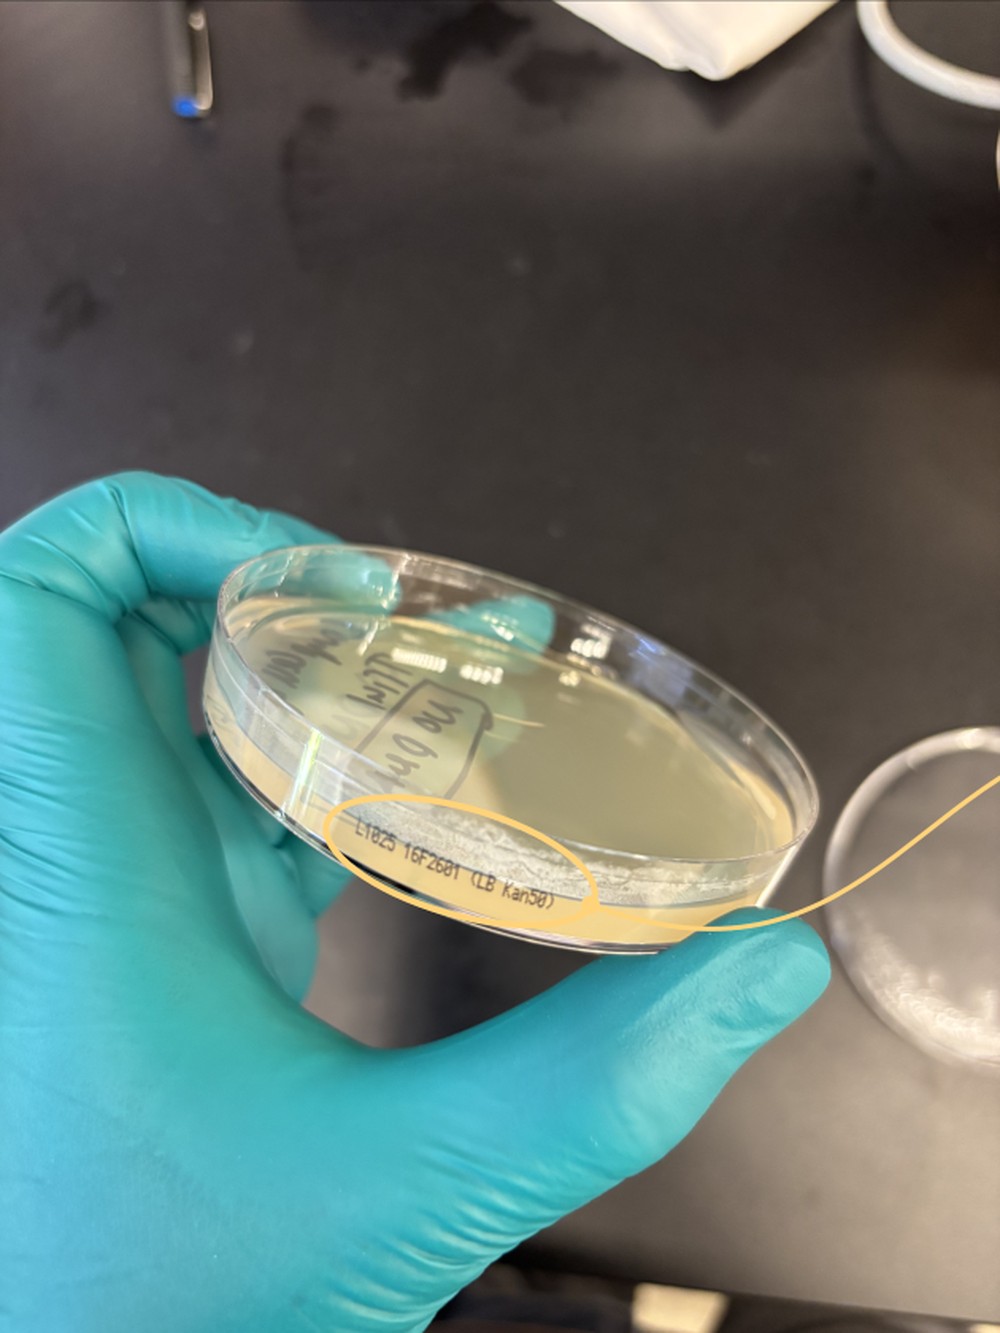
- Masih belum sempurna: contoh hitung koloni kelebihan sekitar 12%; asumsi bisa mengalahkan kontrol
Apa itu BioBasicsBench OpenAI?
BioBasicsBench adalah benchmark OpenAI yang mengukur seberapa baik agen AI menafsirkan bukti eksperimen mentah dari wet lab—bukan sekadar grafik yang sudah dipilih untuk makalah ilmiah. Menurut OpenAI, pekerjaan lab basah sehari-hari penuh eksperimen gagal, citra ambigu, dan observasi yang saling bertentangan; benchmark lama sering melewatkan ambiguitas itu.
Benchmark ini dikembangkan bersama Ligo, perusahaan biotech yang fokus pada desain enzim. Setiap tugas memakai data eksperimen nyata dari ilmuwan, dilengkapi kriteria penilaian ahli, lalu melewati tinjauan internal Ligo, tinjauan eksternal ilmuwan PhD di wet lab, dan tinjauan internal akhir.
Agen diminta memberi jawaban terstruktur: kesimpulan, pengukuran, atau rekomendasi, plus penalaran bila diperlukan. Skor diberikan per kriteria rubrik sehingga analisis sebagian benar tetap bisa dibedakan dari kesimpulan yang tepat. Topik terkait AI OpenAI sebelumnya di Gizmokrat meliputi ChatGPT Images 2.6 dan kenaikan hadiah bug bounty OpenAI.
Bagaimana skor GPT-6 Astra di BioBasicsBench?
Menurut OpenAI, pada pengaturan reasoning effort xhigh, GPT-6 Astra meraih mean reward 66,7% (interval kepercayaan 95% 60,3–73,1%), dibandingkan 43,8% untuk GPT-5.6 Sol dan 62,0% untuk GPT-6.1 Sol. OpenAI menilai tujuh model di 37 kombinasi model dan tingkat reasoning, dengan lima percobaan per tugas untuk total 18.500 hasil.
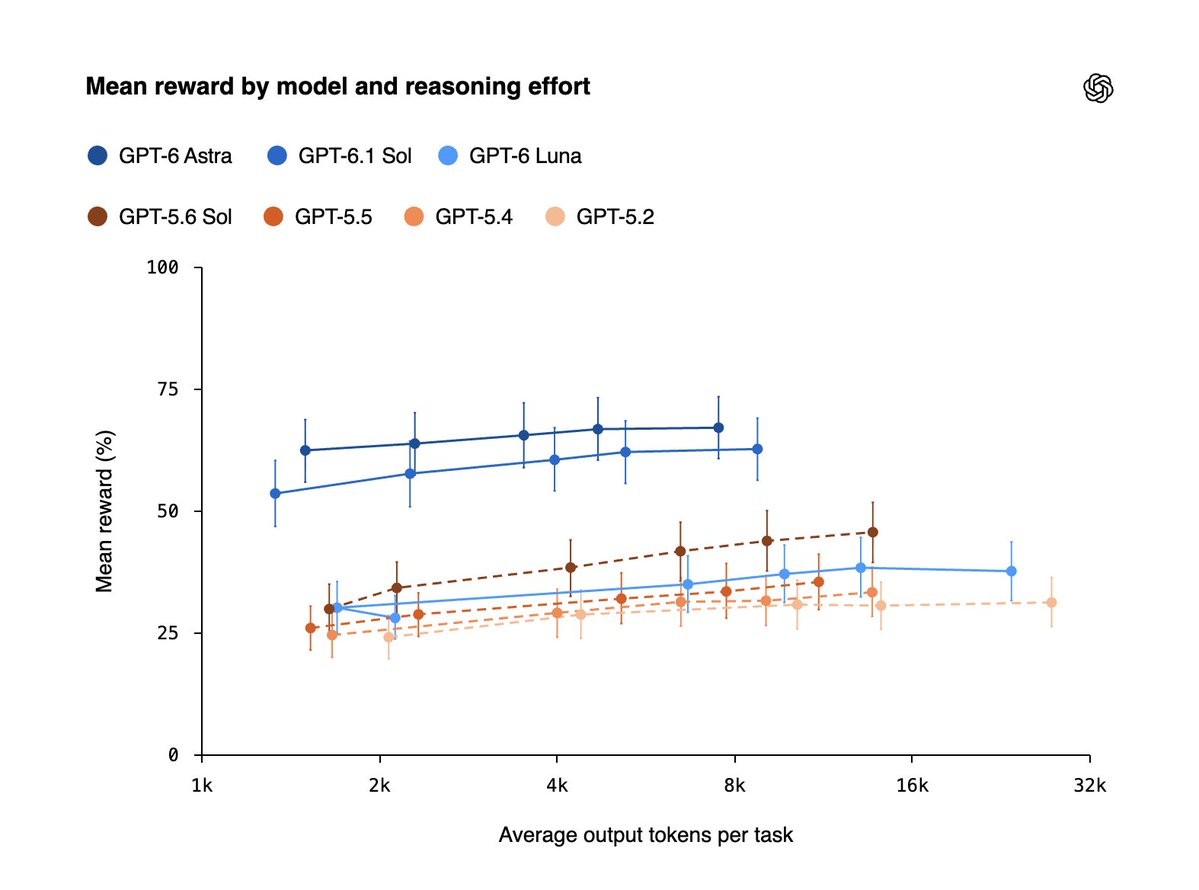
Mean reward berarti rata-rata skor tugas sebagai persentase kredit rubrik yang tersedia, termasuk kredit parsial—bukan 66,7 dari 100 tugas yang sepenuhnya benar. Setiap baris xhigh mencakup seluruh 100 tugas dengan lima percobaan per tugas. Interval kepercayaan dihitung dengan bootstrap per tugas, mempertahankan lima percobaan dalam kelompok yang sama.
| Model | Mean reward (xhigh) | CI 95% | Token keluaran / tugas |
|---|---|---|---|
| GPT-6 Astra | 66,7% | 60,3–73,1% | 4.704 |
| GPT-6.1 Sol | 62,0% | 55,6–68,4% | 5.238 |
| GPT-5.6 Sol | 43,8% | 37,6–50,0% | 9.099 |
| GPT-6 Luna | 38,3% | 32,3–44,5% | 13.120 |
| GPT-5.5 | 35,4% | 29,7–41,0% | 11.135 |
| GPT-5.4 | 33,2% | 28,3–38,4% | 13.717 |
| GPT-5.2 | 31,2% | 26,2–36,3% | 27.620 |
OpenAI menulis bahwa GPT-6 Astra meningkat substansial dibanding GPT-5.6 Sol bahkan pada reasoning effort rendah, dan mengaitkan kemajuan itu dengan kemampuan multimodal yang lebih kuat untuk analisis lab sehari-hari. Untuk konteks benchmark AI lain di Gizmokrat, lihat juga Benchmark GDPx SemiAnalysis.
Apa saja jenis data yang diuji BioBasicsBench?
BioBasicsBench menguji 100 tugas di lima area kerja wet-lab rutin: protein methods, imaging and cytometry, quantification and assays, nucleic acid methods, serta molecular cloning. Menurut OpenAI, input mempertahankan bentuk bukti yang dipakai ilmuwan: gel dan blot, foto cawan dan alat, tumpukan mikroskop, pembacaan sequencing, ekspor plate-reader, hingga video kerja bangku.
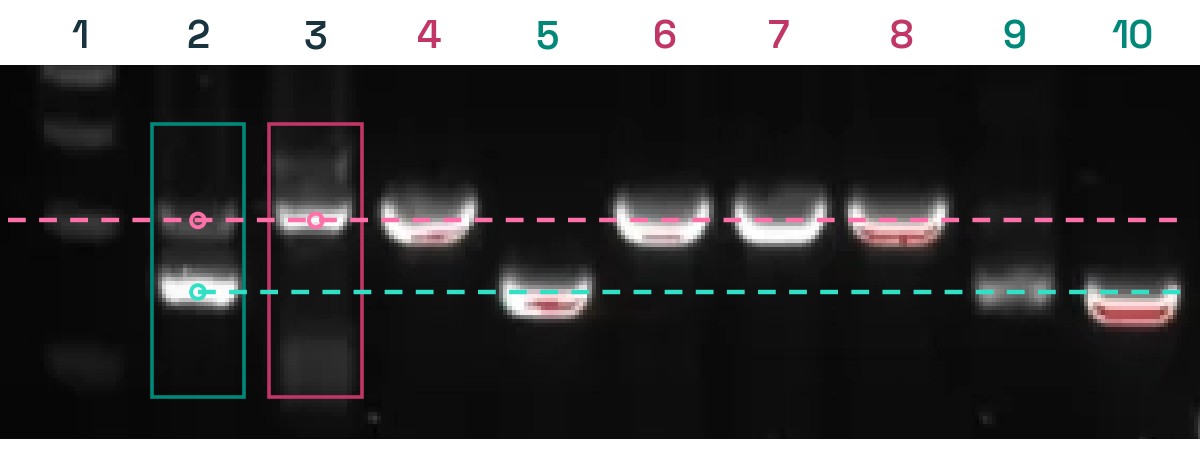
- Gels & blots: 31 tugas (agarose DNA, SDS-PAGE, Western blot)
- Protokol, catatan & spesifikasi: 27 tugas
- Tabel & ekspor instrumen: 20 tugas (termasuk file flow cytometry FCS)
- Foto bangku, alat & reagen: 18 tugas
- Mikroskop: 14 tugas (brightfield, fluoresensi, z-stack, time-lapse)
- Layar instrumen & plot: 13 tugas
- File sequencing: 12 tugas
- Video protokol: 7 tugas; agar plate & koloni: 7 tugas; lembar referensi: 21 (pendukung)
Kategori bisa saling tumpang tindih dalam satu tugas. OpenAI menekankan bahwa salah membaca citra atau mengabaikan masalah pada kontrol eksperimen dapat membuat ilmuwan menarik kesimpulan salah dan membuang waktu pada eksperimen yang tidak menjawab pertanyaan.
Di mana model AI masih kurang menurut OpenAI?
Skor lebih tinggi belum berarti model siap membuat keputusan andal di lab, menurut OpenAI. Contoh kegagalan GPT-6 Astra yang dipublikasikan meliputi asumsi yang mengalahkan kontrol (memilih koloni PCR yang salah), mengabaikan data yang bertentangan dengan interpretasi favorit (kontras vakuola), serta kesalahan hitung koloni dengan kelebihan sekitar 12% pada satu cawan contoh.
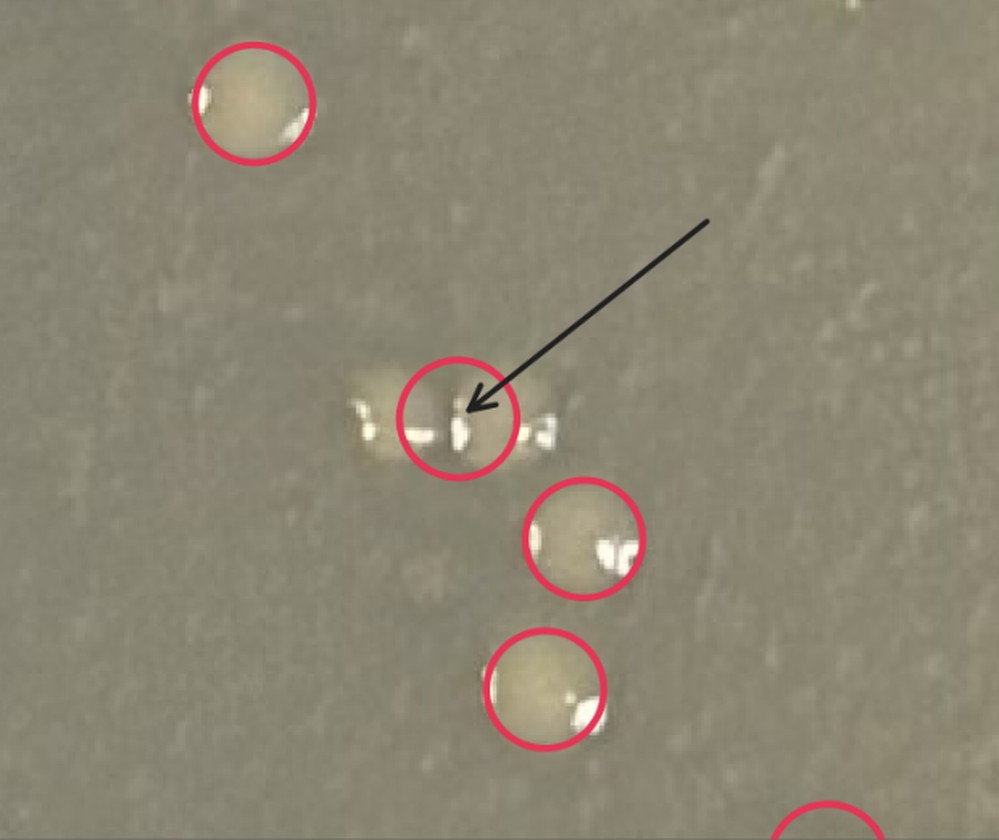
Di sisi kemajuan, OpenAI mengklaim Astra lebih baik mengenali batas apa yang bisa ditunjukkan data, menangani input multimodal (foto, video, sequencing, mikroskop), dan mempertahankan konteks eksperimen—misalnya mengenali z-stack mikroskop alih-alih mencari penjelasan biologi untuk sel yang tampak hilang, atau menolak kontrol negatif yang dilabeli antibiotik salah.
OpenAI menempatkan BioBasicsBench sebagai target perbaikan untuk bantuan lab yang lebih andal, sekaligus membantu memahami implikasi biosafety dan biosecurity. Hasil ini mengukur interpretasi data, bukan pelaksanaan eksperimen fisik secara mandiri, validasi klinis, atau bukti bahwa penggunaan AI di laboratorium sudah aman.
Sumber
- OpenAI Newsroom — Measuring how AI agents handle everyday wet-lab science (6 November 2026)
- X @OpenAI — BioBasicsBench (Sabtu, 7 November 2026 pukul 02.08 WIB)
FAQ seputar BioBasicsBench
Apa itu BioBasicsBench?
BioBasicsBench adalah benchmark OpenAI berisi 100 tugas yang mengukur kemampuan agen AI menafsirkan data mentah eksperimen lab basah. Benchmark ini dikembangkan bersama Ligo, perusahaan biotech desain enzim.
Berapa skor GPT-6 Astra di BioBasicsBench?
Menurut OpenAI, GPT-6 Astra memperoleh rata-rata 66,7% kredit rubrik pada pengaturan xhigh, mencakup 100 tugas dengan lima percobaan per tugas. Ini bukan tingkat keberhasilan eksperimen fisik.
Kapan BioBasicsBench diumumkan?
OpenAI Newsroom memublikasikan BioBasicsBench pada 6 November 2026. Akun X @OpenAI membagikannya pada Sabtu, 7 November 2026 pukul 02.08 WIB.
Apa saja lima area yang diuji BioBasicsBench?
Menurut OpenAI, lima area wet-lab rutin yang diuji adalah protein methods, imaging and cytometry, quantification and assays, nucleic acid methods, dan molecular cloning.
Apakah skor tinggi berarti AI sudah andal di lab?
Tidak otomatis. OpenAI menekankan skor lebih tinggi belum berarti model siap membuat keputusan andal di lab; contoh kegagalan mencakup salah hitung koloni sekitar 12% dan asumsi yang mengalahkan kontrol.